Le monstre final : 32 GPU et 1 To de VRAM
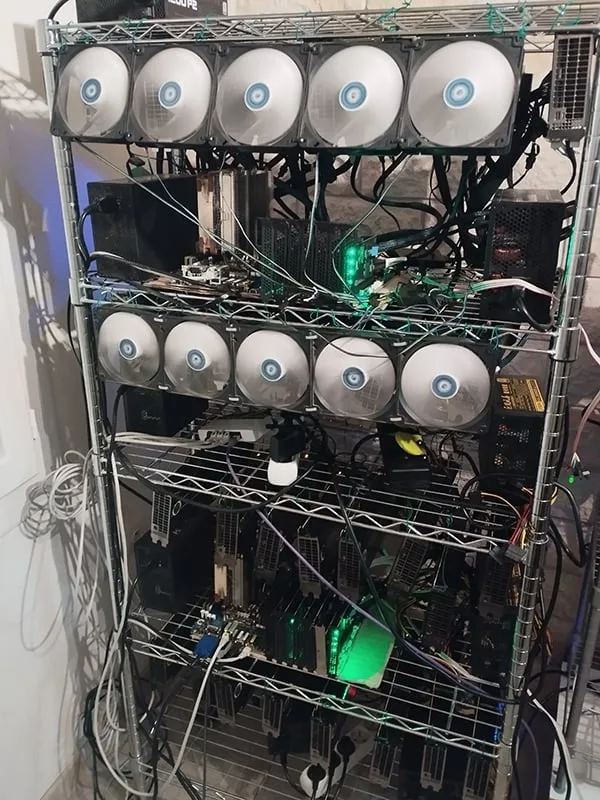
- 32× AMD MI50 32 Go - 1 téraoctet de VRAM
- Kimi K2.6 int4 : 9,7 tokens/s en génération · ~264 tokens/s en prompt processing
- Architecture : 2 noeuds de 16 GPU reliés en Ethernet 10 Gb
- ~640 W au repos / ~4 800 W en crête d'inférence
- Mon verdict honnête : sans énergie gratuite, ce n'est pas un bon calcul
Après les 16 GPU, il ne me restait qu'une marche : le monstre. Deux noeuds de 16 GPU, simplement reliés par un câble Ethernet 10 Gb. Un téraoctet de VRAM sur une étagère, à la maison. De quoi charger Kimi K2.6, un modèle de plus d'un billion de paramètres, entièrement en local : 9,7 tokens/s en génération, ~264 tokens/s en prompt processing.
Est-ce que je suis fier du résultat ? Oui. Est-ce que je le referais ? Non. Et je l'ai écrit tel quel dans le post : à moins d'avoir des panneaux solaires ou de l'énergie gratuite, ce montage ne se justifie pas. Au repos il tire ~640 W, et en pleine inférence il grimpe à ~4 800 W - la puissance d'un chauffe-eau, en continu.
Et pour être tout à fait transparent : avant de prendre la photo, le monstre était éteint. Je l'avais allumé uniquement pour ça. Mon but était de montrer une chose : un jour, on pourra charger une AGI en local, en additionnant des GPU grand public. Ce jour n'est pas encore là - mais on en est beaucoup plus près qu'on ne l'imagine.
La fin d'une ère (et le début d'une autre)
Avec un peu plus de temps sur ce montage, je suis persuadé qu'on pourrait faire bien mieux : mes risers étaient instables (3,5 Go/s au lieu des 7 Go/s attendus), et une pile logicielle mieux optimisée devrait permettre d'atteindre 600–1 000 tokens/s en prompt processing et 10–12 tokens/s minimum en génération. Mais j'ai décidé d'en rester là. Les petits modèles sur les petits rigs sont tout simplement plus rapides, plus économes en énergie et plus agréables au quotidien - et c'est là que se joue la vraie vie de l'IA locale.
Ce que la communauté m'a demandé
83 commentaires, beaucoup d'humour (« j'ai senti un grand trouble dans le réseau électrique »), et de vraies questions :
- « 640 W au repos ?! C'est énorme. »
- Oui, et c'est le vrai coût caché des gros rigs : ventilateurs, cartes PCIe switch, la machine elle-même. La réponse est simple : on éteint quand on ne s'en sert pas. Beaucoup de membres du subreddit font comme moi - la machine ne tourne que quand elle sert.
- « Alors, ça vaut le coup ? »
- Pour apprendre et repousser les limites : clairement oui. Pour un usage quotidien : non, sauf énergie gratuite. D'où mon retour vers des montages plus modestes et plus efficaces.
- « Pourquoi la vitesse de génération ne monte pas avec le nombre de GPU ? »
- Parce que la génération est limitée par la bande passante mémoire, pas par la puissance de calcul - ajouter des cartes ne la fait pas exploser. Le prompt processing, lui, profite beaucoup plus de la puissance de calcul ajoutée.