Mon premier rig IA local : 8 GPU, 256 Go de VRAM, 880 $
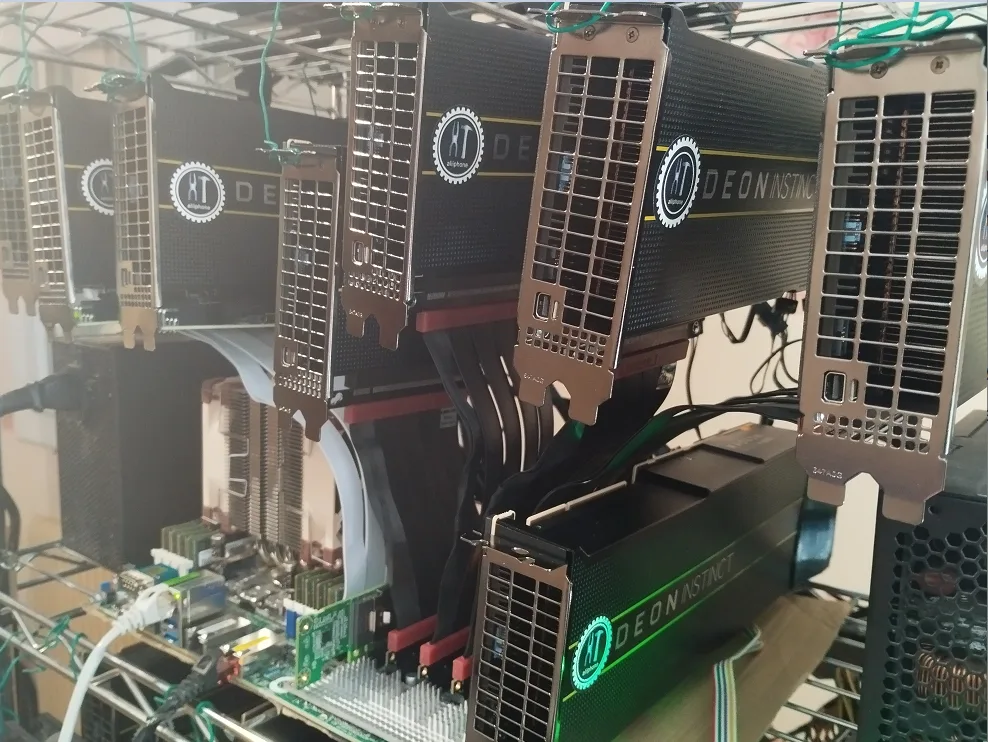
- 8× AMD MI50 32 Go - 256 Go de VRAM
- Cartes : 880 $ (débuts 2025)
- MiniMax-M2.1 : 26,8 tokens/s en génération
- GLM 4.7 : 15,6 tokens/s · GLM 4.6 : 12 tokens/s
- 280 W au repos / 1 200 W en inférence
- Contexte jusqu'à 196 000 tokens (MiniMax)
Pour la petite anecdote, le rig AMD ne correspond pas vraiment à mon premier rig IA. Tout a commencé avec la carte NVIDIA GTX 1060 puis 2060 de mes PC portables à faire tourner les modèles Gemma (de chez Google) avec ollama puis llama.cpp. Puis je suis passé à la vitesse supérieure à monter le premier serveur IA avec 6 NVIDIA RTX 3090 (144 Go VRAM) sous vllm.
Je me suis ensuite posé la question: est-ce que je continue la voie NVIDIA avec 8 RTX 3090 et plus, sachant que ces cartes sont de plus en plus chères et difficiles à trouver (sur tous les marchés: neuf comme occasion) ? Ou bien existe-t-il des alternatives plus abordables, méconnues du grand public et surtout à quasi capacité équivalente (bonne vitesse de la bande passante, des coeurs puissants, et mémoire VRAM élevée: le tryptique gagnant pour de la haute performance IA).
En résumé: est-ce qu'on peut faire tourner de vrais grands modèles d'IA chez soi, à une vitesse raisonnable et sans se ruiner ? Pas une maquette, pas un jouet - de quoi bosser tous les jours avec un modèle intelligent, en local.
Ma réponse a été un pari un peu fou : des AMD MI50. Ce sont des cartes de datacenter de 2019, en fin de vie commerciale, que les centres de données revendaient pour presque rien. Chacune embarquait 32 Go de VRAM à 1024 Go/s HBM2 et 26 TFLOPS FP16. Début 2025, on en trouvait à ~110 $ pièce. Huit cartes, et voilà 256 Go de VRAM pour 880 $ - très loin du prix affiché pour une seule carte haut de gamme du moment.
Le vrai défi, ce n'était pas le matériel : c'était le logiciel. Ces cartes ne sont plus supportées officiellement par AMD. Mais la communauté open source a fait des miracles, et j'ai ajouté ma pierre avec mes adaptations de vLLM pour ces GPU. Merci encore à la communauté open source mondiale pour tout ça.
Ce que ça donne au quotidien
Avec MiniMax-M2.1, j'obtiens 26,8 tokens/s en génération, avec un contexte maximal de 196 000 tokens. Avec GLM 4.7, 15,6 tokens/s. Et tout ça tourne sous 1 200 W en pleine inférence, 280 W au repos. Pour un modèle de cette taille qui tourne entièrement à la maison, c'était un des montages les plus rentables du moment - c'était même mon objectif affiché : viser la solution la plus rentable possible pour une inférence locale rapide et intelligente.
Je l'utilisais surtout pour du code : Roo Code (github archivé actuellement) branché sur le rig, et c'était parti. Je dis tout de suite que certains chiffres que j'ai publiés au départ étaient trop beaux : les vitesses de prompt processing affichées dans les logs de vLLM ne traduisaient pas la réalité. Les vraies valeurs mesurées, je les donne plus bas - je préfère corriger moi-même que laisser des chiffres trompeurs traîner.
Ce que la communauté m'a demandé
Le post Reddit a fait +300 upvotes et plus de 120 commentaires. Voici les questions qui reviennent.
- « Quelle carte mère pour 8 GPU ? »
- Une ASRock Rack ROMED8-2T (7 ports PCIe 4.0 x16). Mais j'ai aussi fait tourner GLM 4.6 sur une carte de minage à moins de 200 $ avec des risers x1 : stable jusqu'à ~60k tokens de contexte, avec une vitesse un peu moindre (~7 tokens/s). Tout est dans les guides.
- « C'est bruyant ? »
- Les cartes ont leurs ventilateurs 50 mm d'origine. Ça reste sous 70 °C, mais c'est bruyant : une pièce fermée séparée est le mieux, à mon avis.
- « Où acheter ces cartes et le matériel associé, et quel est le piège ? »
- Alibaba, Amazon, eBay, AliExpress, etc. Le piège : les MI50 ont beaucoup monté depuis 2025, et AMD ne les supporte plus officiellement. En pratique, la communauté fait tourner ROCm 7.2+ dessus, et ça marche plutôt bien.