40× RTX 5070 Ti : le rig qui fait tourner AgentVUE
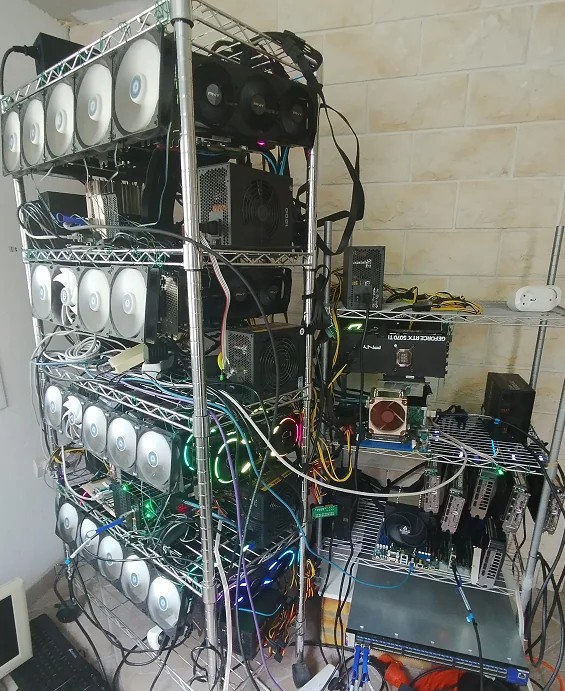
- 40× RTX 5070 Ti - 640 Go de VRAM
- Architecture : 4 noeuds (11 + 11 + 10 + 8 GPU), chaque noeud relié au switch par son propre câble InfiniBand 56 Gb/s (cartes ConnectX-3 Pro)
- Par commande vLLM de 20 GPU, une requête simple : 5 200 tokens/s en prompt processing et 142 tokens/s en génération
- 8 agents en parallèle : 5 500+ tokens/s en prompt processing, 800 tokens/s en génération au total
- Contexte : 315 000 tokens (TP4, PP5)
- Deux commandes de ce type tournent sur les 40 GPU : débit doublé
- Extensible à 44 GPU si besoin
Après le monstre à 1 To de VRAM, le retour à la raison - mais pas au rabais. Le rig actuel abandonne les cartes de datacenter vieillissantes pour des GPU grand public récents : 40 RTX 5070 Ti, soit 640 Go de VRAM, montées sur étagères comme les précédentes.
Et là, la différence saute aux yeux. Sur une commande vLLM de 20 GPU, une requête simple atteint 5 200 tokens/s en prompt processing et 142 tokens/s en génération. Là où ce rig change vraiment la vie, c'est en usage agentique : avec 8 agents qui travaillent en parallèle, la commande enchaîne 5 500+ tokens/s en prompt processing et 800 tokens/s en génération au total, avec 315 000 tokens de contexte. Et comme les 40 GPU se partagent deux commandes de ce type, le débit double simplement, atteignant 10 000+ tokens/s et 1 600 tokens/s en prompt processing et génération respectivement.
C'est ce genre de débit qui rend possible ce que je construis avec AgentVUE : plusieurs agents qui lisent, écrivent et vérifient en même temps, sur du matériel qui m'appartient, sans qu'aucune donnée ne quitte la maison. La photo ci-dessus date d'octobre 2026 : depuis, le rig a encore reçu quelques améliorations dont je discuterai dans un prochain article.
Pourquoi des 5070 Ti ?
En deux mots : l'efficacité. Les MI50 étaient un pari génial à 150 € la carte, mais leur conso au repos et leur âge commençaient à peser. Les GPU grand public récents offrent un bien meilleur équilibre entre performance, consommation et silence - et surtout, une pile logicielle soutenue au quotidien. Le guide détaillé du montage arrive ; en attendant, tous les chiffres clés sont dans l'encadré plus haut.
L'interconnexion : InfiniBand, pas Ethernet
Un détail change tout : les 4 noeuds ne communiquent pas entre eux par Ethernet. Chacun est raccordé au switch Mellanox par son propre câble InfiniBand 56 Gb/s, via des cartes ConnectX-3 Pro. Résultat : la latence P2P entre cartes de noeuds différents s'effondre. Concrètement, le tensor parallelism de vLLM réparti sur plusieurs noeuds ne perd que ~5 % de vitesse d'inférence, contre plus de 50 % avec un lien Ethernet équivalent.
Les deux commandes vLLM de 20 GPU sont réparties différemment sur ces noeuds : l'une s'étend sur 3 noeuds, l'autre sur 4. Et entre les deux commandes, la perte de performance est quasi nulle - la meilleure preuve de l'efficacité d'InfiniBand.
Et après ?
Le châssis peut accueillir 44 GPU : aujourd'hui j'en utilise 40, et les 4 suivants sont prévus pour un futur montage. La boucle est bouclée : de 8 GPU d'occasion à 880 $ jusqu'ici, chaque étape a servi à répondre à la même question - jusqu'où peut-on aller avec du matériel abordable ? De plus en plus loin, visiblement.
- « 40 GPU, ça consomme combien ? »
- Je publierai les mesures exactes avec le guide complet. Ce que je peux déjà dire : avec des cartes récentes, le rapport performance/watt n'a rien à voir avec la génération précédente - et la machine s'éteint quand elle ne sert pas, comme toujours.
- « Vous vendez les rigs ? »
- Non - mais je partage tout : guides, forks et benchmarks sont en accès libre sur les liens AI-INFOS ci-dessous. Et ce que je construis avec tout ça, AgentVUE, est disponible pour tous.