Passer à 16 GPU : DeepSeek v3.2 et Qwen3.5 en local
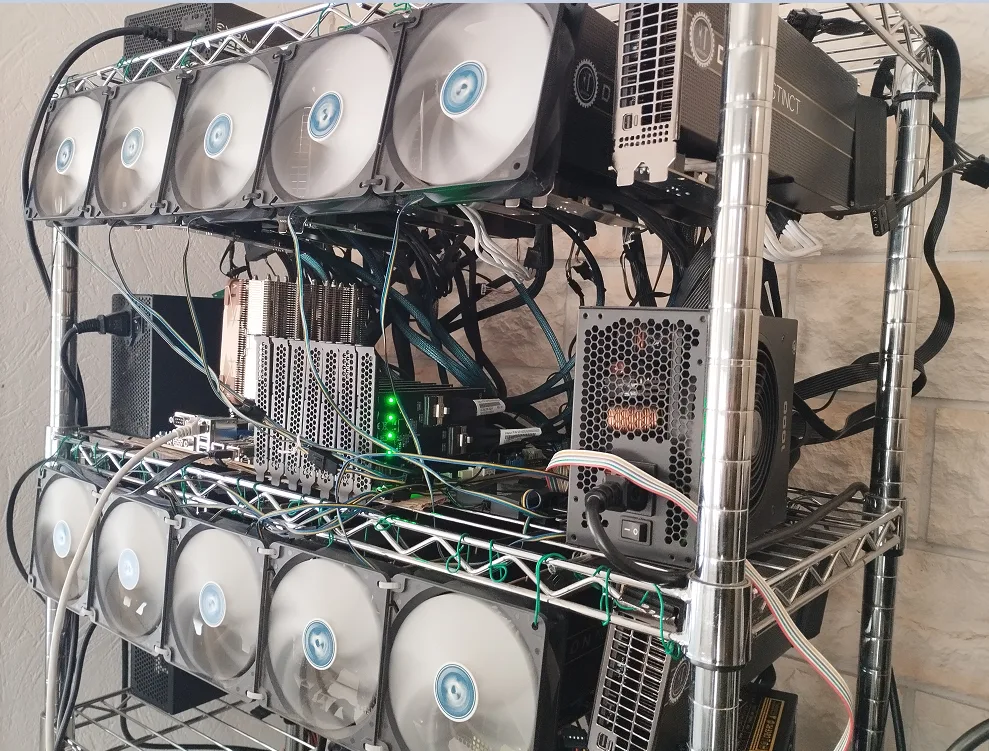
- 16× AMD MI50 32 Go - 512 Go de VRAM
- Coût total : ~5 600 € (~150 €/carte à l'époque)
- Qwen3.5 397B : 32 tokens/s en génération
- DeepSeek v3.2 : 10 tokens/s en génération
- 550 W au repos / 2 400 W en crête
- Correction honnête : le vrai prompt processing mesuré est ~56 tokens/s (la vitesse affichée dans les logs de vLLM était trompeuse)
Après le rig de 8 GPU, la suite logique : doubler. Deux fois plus de VRAM, et surtout l'accès à une autre catégorie de modèles - ceux qui ne rentrent tout simplement pas dans 256 Go.
Avec 512 Go de VRAM, DeepSeek v3.2 en 4 bits tourne à 10 tokens/s en génération. Et quand Qwen3.5 397B est sorti, j'ai pu le faire tourner à 32 tokens/s - un modèle de près de 400 milliards de paramètres, chez moi, à une vitesse tout à fait utilisable au quotidien.
Une précision importante, que j'ai ajoutée sur tous mes posts : dans un premier temps, j'ai repris tel quel le chiffre de prompt processing affiché par les logs de vLLM (2 000 tokens/s). En le mesurant moi-même de bout en bout, la vraie valeur est bien plus basse. Je préfère le dire clairement : les chiffres affichés par les outils ne sont pas toujours des chiffres réels. Mesurez.
Un objectif, pas une collection
Je ne collectionne pas les GPU. Mon objectif est clair : être prêt pour une AGI locale, sans dépenser plus de 300 000 $. Je ne suis pas un laboratoire géant avec un budget infini - juste un constructeur déterminé, et si j'y arrive, beaucoup d'autres peuvent y arriver. C'est aussi pour ça que je publie tout : chaque montage a son guide détaillé, ouvert à tous.
Ce que la communauté m'a demandé
Le post DeepSeek a fait plus de 450 upvotes et 245 commentaires - de loin le plus populaire de la série. Les questions qui reviennent :
- « Le coût total ? »
- ~5 600 € tout compris, avec des cartes à ~150 € à l'époque. Ce n'est plus le cas : les MI50 ont pris beaucoup de valeur depuis. Le même montage coûterait aujourd'hui nettement plus cher.
- « 2 400 W chez soi, comment c'est possible ? »
- En Europe, chaque bloc d'alimentation de 1 600 W est branché sur son propre circuit. Avant de tirer quoi que ce soit, j'ai cartographié les disjoncteurs de la maison pour savoir exactement ce que chaque circuit peut encaisser. Faites pareil - et faites-vous aider si vous avez un doute.
- « Pourquoi du local, quand le cloud paraît moins cher ? »
- Pour l'autonomie, l'indépendance, la sécurité et la confidentialité, pas pour le coût par token. Et parce que je veux savoir, dès aujourd'hui, si le matériel d'occasion peut faire tourner les modèles de demain en local. Verdict : oui.
- « Et la stabilité sur les longs contextes ? »
- DeepSeek v3.2 a montré des sorties incohérentes au-delà de ~18 000 tokens de contexte dans mes tests. MiniMax et GLM, eux, sont restés stables sur les longs contextes - ce sont eux que j'utilise pour les agents de code. (UPDATE: depuis la v0.17 de mon fork vllm-gfx906-mobydick, les problèmes de cohérence DeepSeek v3.2 ont été corrigés et il reste stable sur la totalité de son contexte)